


Le contexte
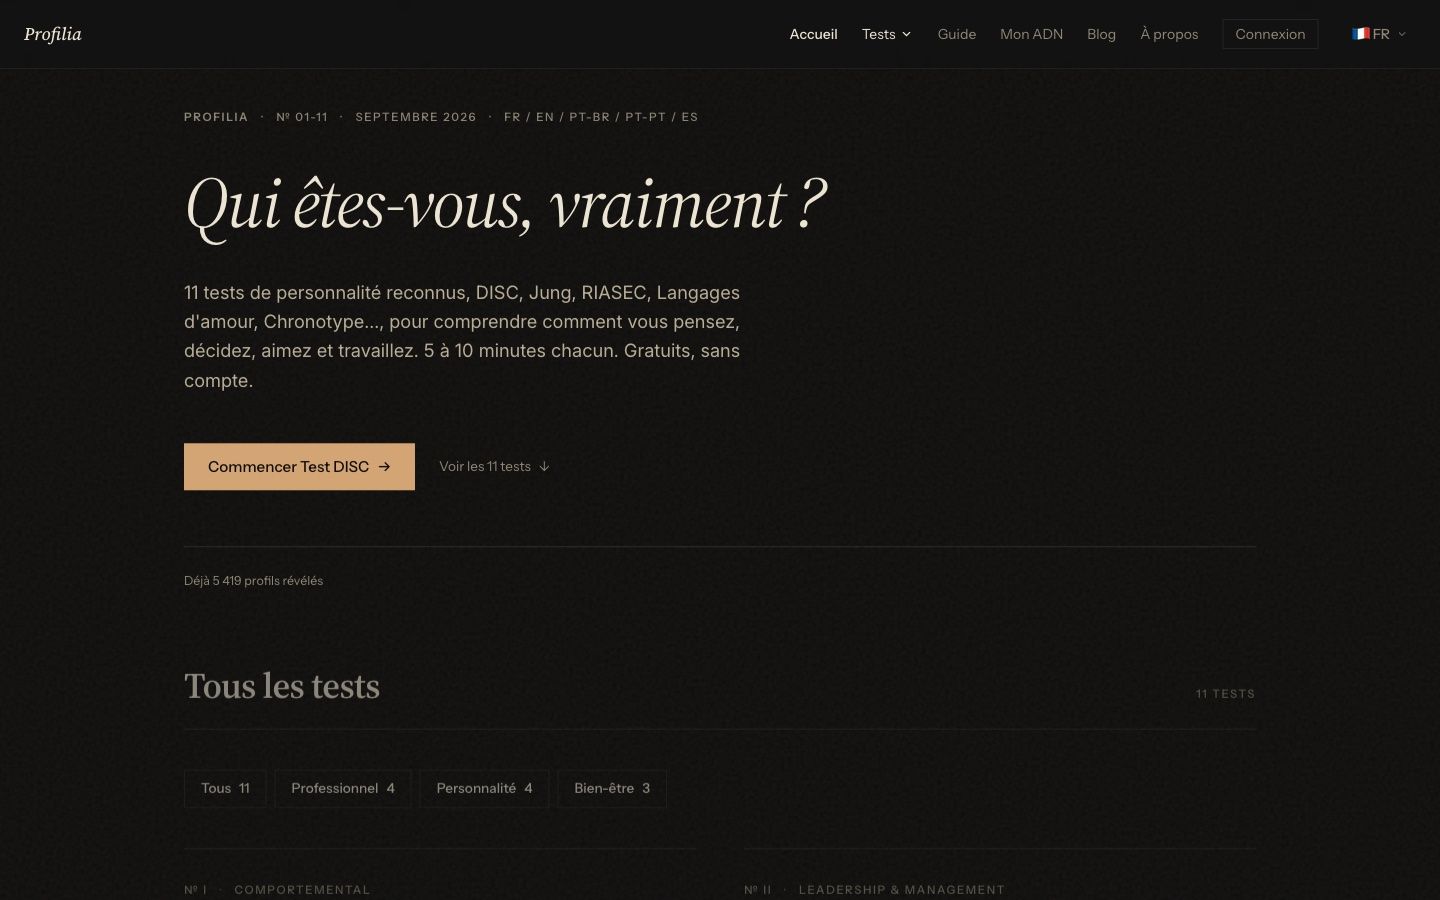
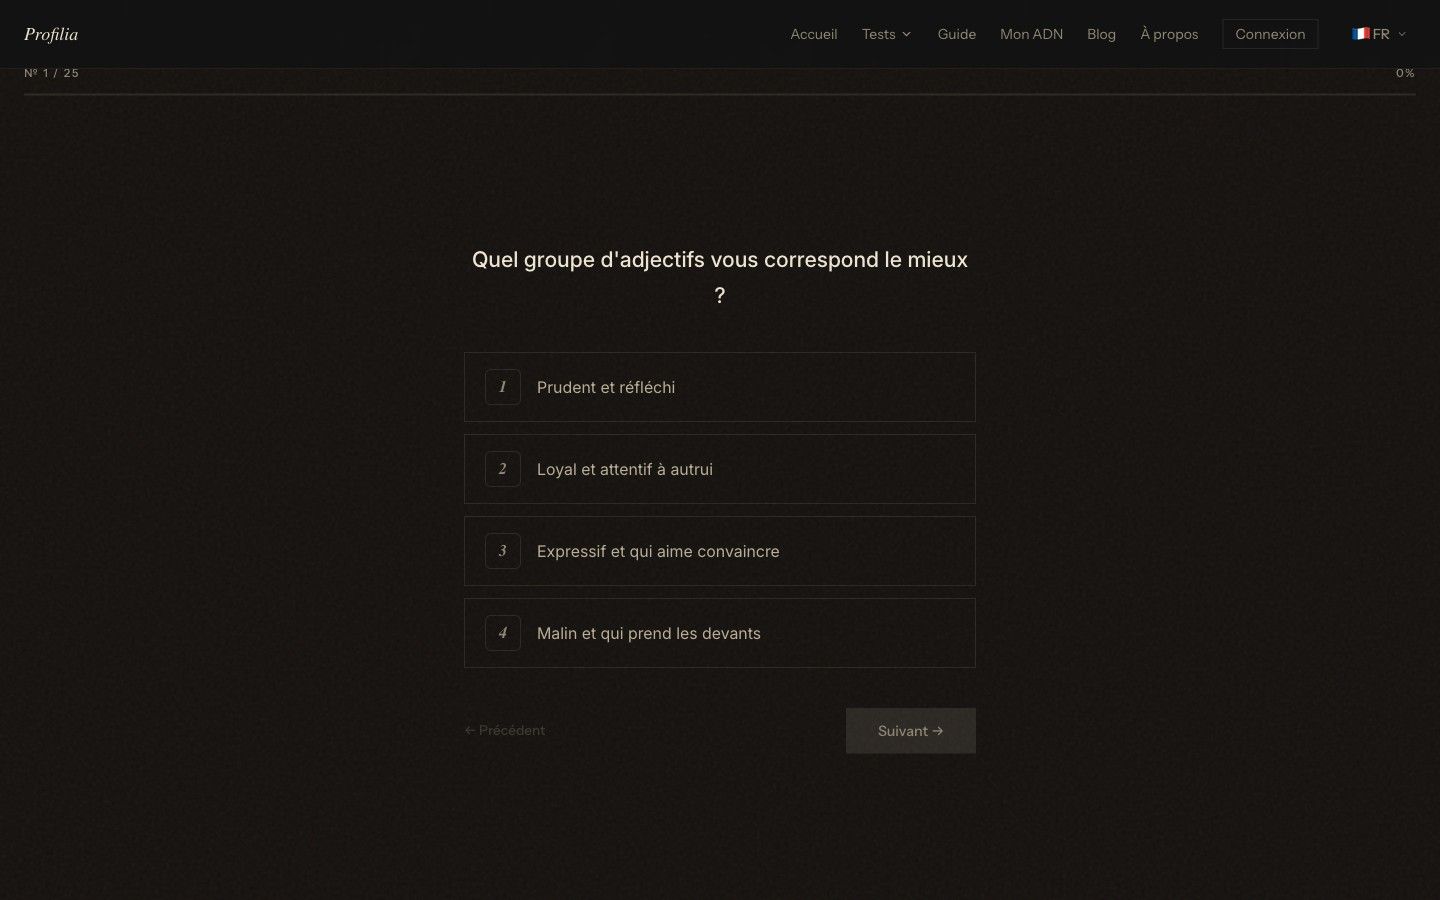
Profilia est un site de tests de personnalité que je construis seul depuis le 13 mars 2026. Vous répondez, vous avez votre résultat complet à l’écran, vos scores dimension par dimension et ce qu’ils veulent dire. C’est gratuit. Le compte existe si vous voulez garder vos résultats d’un test à l’autre, il n’est obligatoire nulle part.
Au départ, c’était une hypothèse à éprouver : est-ce qu’en empilant des tests reconnus, plusieurs langues et des dizaines d’articles de fond par thème, on peut construire un site qui trouve son public tout seul, par les moteurs de recherche ?
Six mois plus tard, le site a trouvé son public, mais pas par où je l’attendais. Deux choses que je n’avais pas anticipées.
Le français est devenu minoritaire sur mon propre site. Sur les trente derniers jours, il pèse 30 % des tests terminés, à égalité avec le portugais du Brésil, et l’espagnol suit de près. Le Brésil est le premier pays du site, devant la France et le Mexique.
Et mon premier canal d’arrivée n’est pas Google. Sur les trente derniers jours, Bing arrive en tête, ChatGPT juste derrière, Google seulement en troisième. Dès le début, le site a été construit pour qu’une IA sache le lire, l’indexer et le citer. Ça a porté ses fruits, et ça a changé la nature du projet : une bonne partie de ceux qui arrivent par une IA sont des enseignants, des formateurs ou des managers qui cherchent un test à faire passer à un groupe. Un matin, 41 personnes sur un même réseau éducatif québécois ont terminé le même test en huit minutes.
Je ne l’ai pas su en le devinant. Je l’ai su parce que j’ai construit l’outil de mesure qui me le disait.
Le défi
Plusieurs contraintes à tenir en même temps :
- Multilinguisme réel : français, anglais, portugais brésilien, portugais européen et espagnol, sur les tests, les profils, le blog et l’interface, sans duplication de contenu ni pénalité de référencement.
- Des résultats honnêtes : un test de personnalité peut facilement dire à chacun ce qu’il a envie d’entendre. Il fallait des textes qui décrivent des tendances mesurées, avec des sources vérifiables, et dire clairement ce que chaque test mesure et ce qu’il ne mesure pas.
- Servir un groupe, pas seulement une personne : un professeur qui fait passer un test à trente élèves n’a pas besoin de trente résultats isolés, il a besoin de voir la classe.
- Une mesure à laquelle je peux me fier : robots, liens relayés par Gmail ou Classroom qui se font passer pour une recherche Google, applications mobiles qui n’indiquent pas leur provenance. Sans un moyen de trier tout ça, tous les taux affichés sont faux et les décisions produit qui en découlent le sont aussi.
- Ne pas dépendre d’un seul canal : quand une part de la croissance vient des recommandations d’une IA, un concurrent qui publie la bonne page peut vous en faire sortir du jour au lendemain.
Ce que j’ai fait
Produit
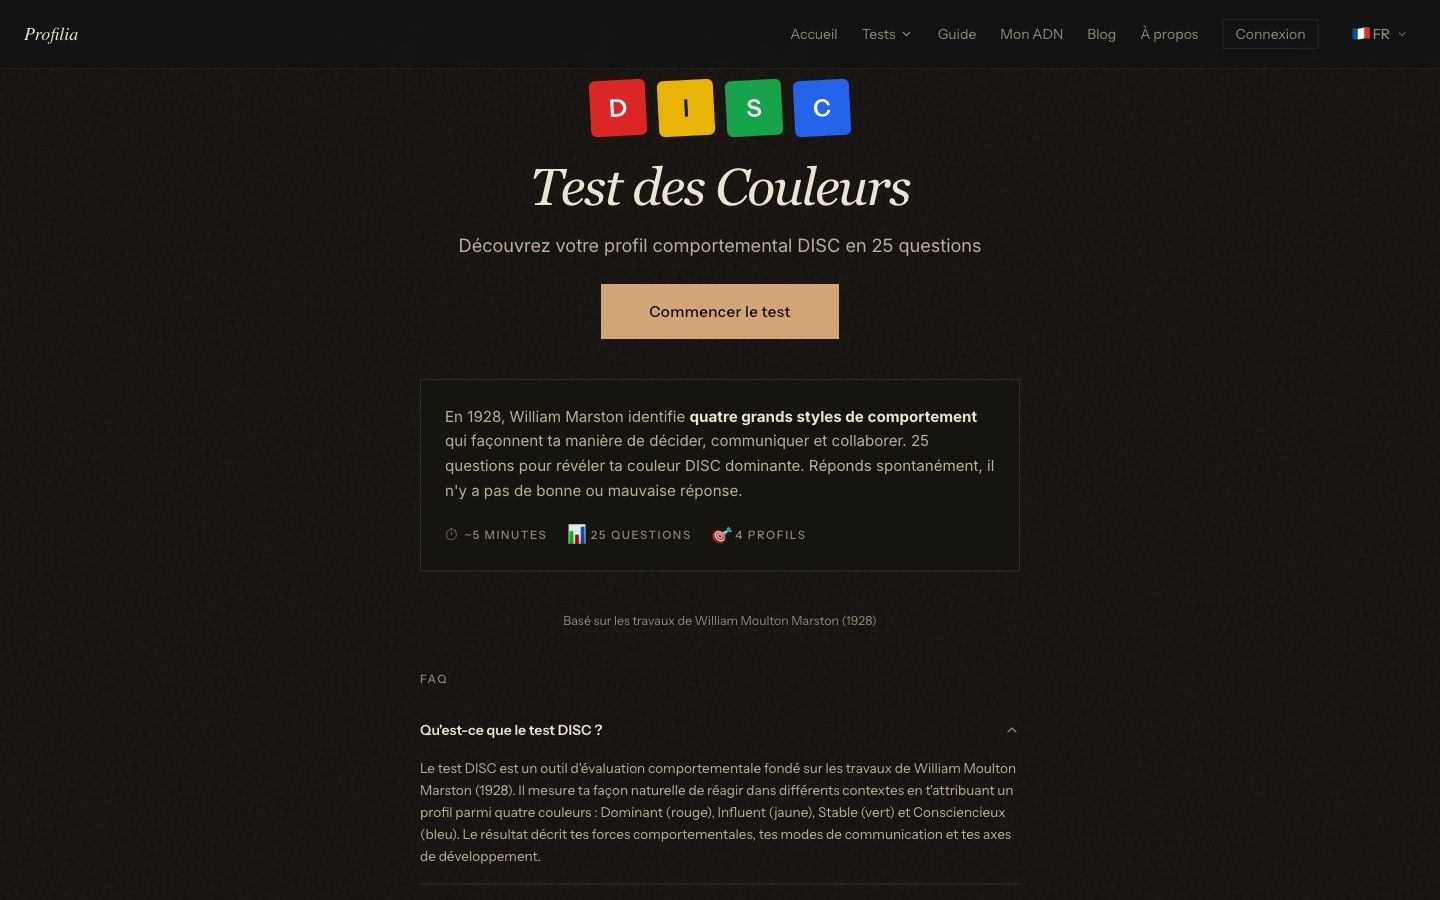
- Onze tests : DISC, Big Five, RIASEC, archétypes de Jung, Tempéraments, Chronotype, VARK, Langages de l’amour, Quatre Tendances, Styles de leadership, Animal totem. Le Big Five s’appuie sur l’IPIP-50, un questionnaire du domaine public utilisé en recherche.
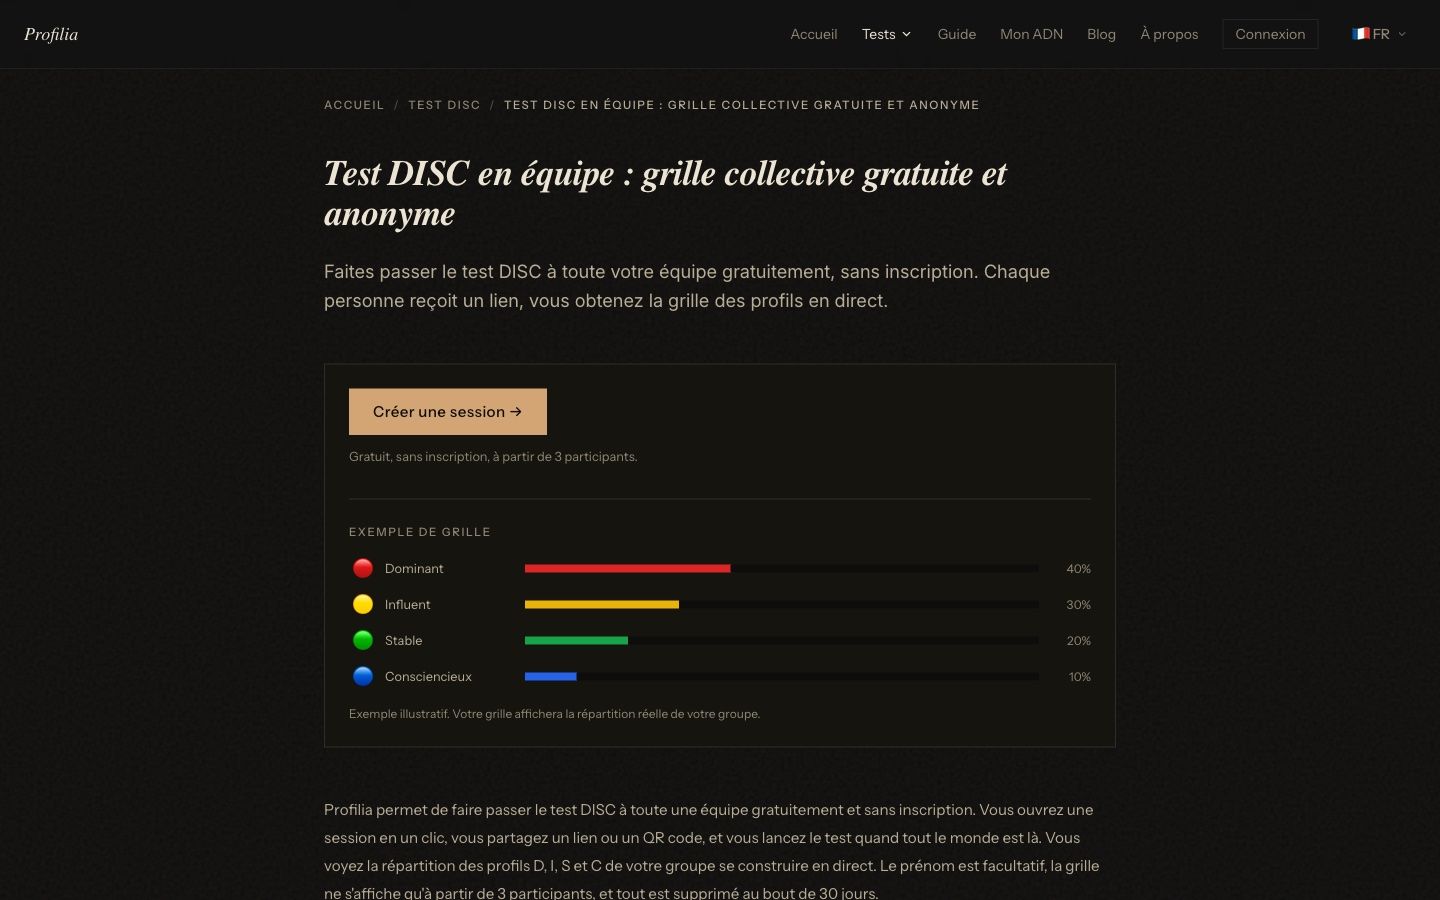
- Mode Groupe, sur sept des onze tests : un animateur crée un groupe, partage un lien ou un QR code, et chacun passe le test de son côté. L’animateur voit ensuite la grille de la salle, avec pour chaque profil présent la manière de l’aborder, et peut l’imprimer. Chaque test a sa page dédiée aux équipes et aux classes ; ChatGPT s’est mis à les citer, et elles amènent chaque semaine de nouveaux animateurs sans que j’aie rien à faire.
- Résultat en PDF, sans compte : le document est fabriqué directement dans le navigateur, rien ne transite par le serveur.
- Montrer son calcul : chaque test explique comment son score est obtenu, règle dérivée du barème lui-même, pour qu’on puisse vérifier le résultat plutôt que le croire.
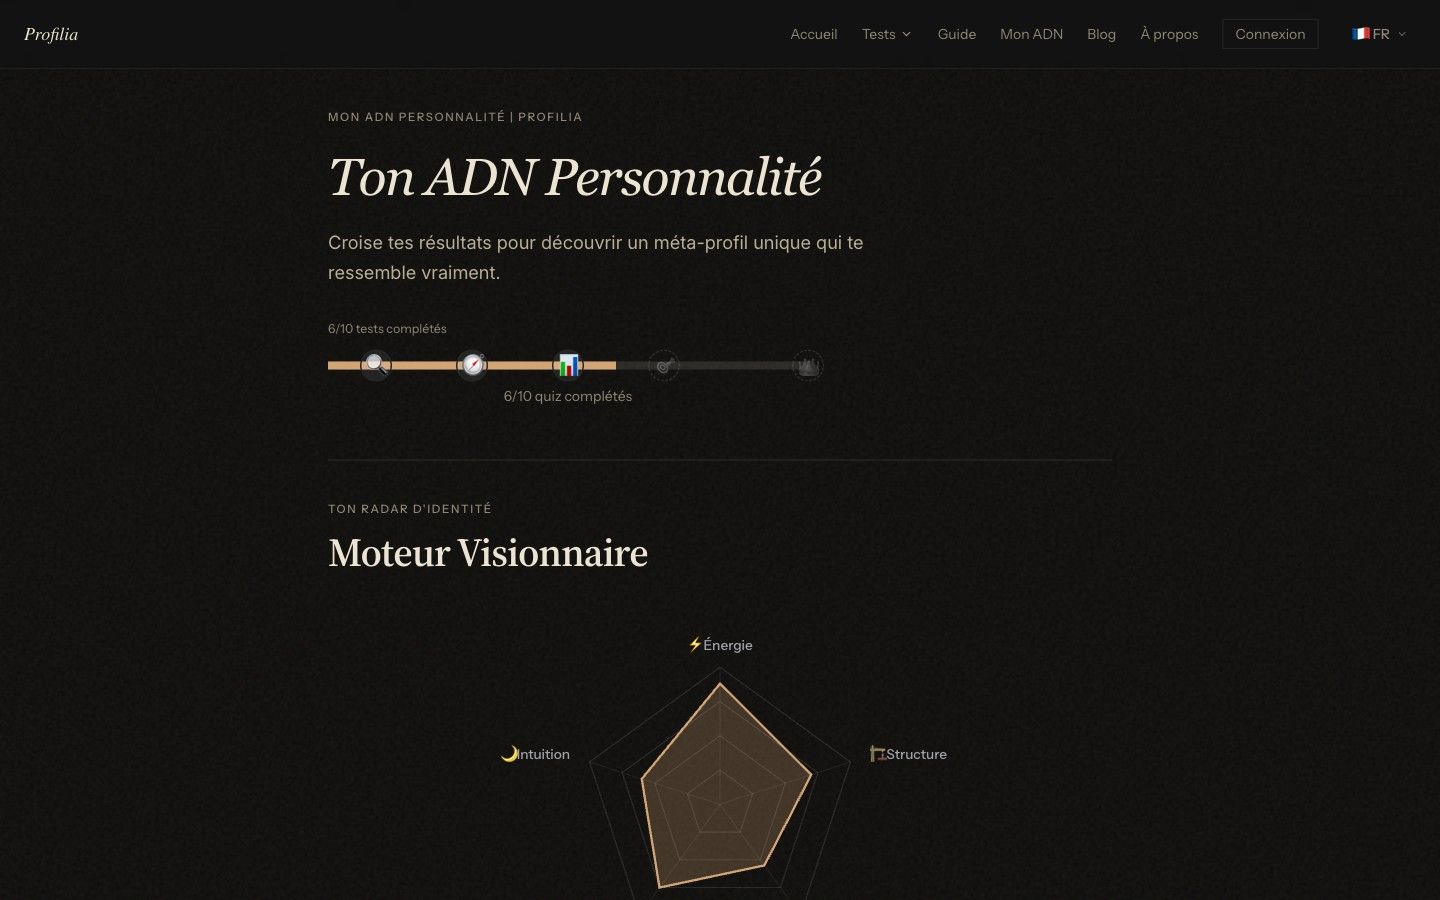
- ADN personnalité : un méta-profil qui se débloque dès deux tests complétés et s’enrichit à chaque nouveau test. Il est calculé dans le navigateur et n’est enregistré sur le serveur que si l’utilisateur choisit de le partager.
- Comparaison à deux, et cinquante pages de compatibilité entre profils DISC.
- Connexion avec Google uniquement, proposée après le résultat pour qui veut conserver ses tests. Aucun mot de passe à créer.
Rigueur scientifique
En septembre, John A. Johnson, chercheur à Penn State qui gère le site de l’IPIP, le réservoir de questionnaires dont est issu le Big Five de Profilia, a répondu à mes questions sur la façon d’interpréter les scores. Sa réponse a lancé une relecture complète de tous les tests, dans les cinq langues :
- les textes de résultat décrivent désormais des tendances, et les phrases flatteuses qui conviendraient à tout le monde ont été retirées ;
- les affirmations sans source ont été supprimées, les citations et les dates ont été vérifiées dans les publications d’origine ;
- l’ordre des réponses proposées a été revu pour neutraliser le biais de position, c’est-à-dire la tendance à choisir plus souvent la première option ;
- le Big Five n’annonce plus de « facteur dominant » : il montre les cinq scores sans les classer, comme le recommandent les auteurs de l’instrument ;
- une page de méthodologie publique indique, pour chaque test, sur quelle base il repose et ce qu’on peut en conclure.
Tech
- Développé entièrement avec des agents IA : je conçois, Claude Code exécute, encadré par dix agents spécialisés, des hooks et des règles écrites. Il n’y a pas d’IA dans le produit lui-même. La méthode est détaillée sur une page dédiée.
- Pile technique Laravel 13, PHP 8.4, Blade et Alpine.js, base PostgreSQL 16, rendu côté serveur natif : chaque page de résultat ou d’article arrive complète et indexable.
- Les onze tests sont décrits dans des fichiers de configuration PHP, pas en base de données : questions, calcul du score, profils, SEO et FAQ au même endroit, versionnés avec le code. Le calcul tourne côté navigateur pour que le résultat s’affiche instantanément ; pour éviter que les deux versions divergent en silence, l’intégration continue régénère les cas de test JavaScript depuis les configurations PHP et bloque la mise en production au moindre écart.
- Internationalisation paramétrique : ajouter une langue, c’est déposer les fichiers de contenu et ajouter une ligne de configuration, sans toucher à la structure. C’est ce qui a permis de passer d’une langue à cinq en quatre mois.
- Environ 2 000 tests automatisés côté serveur, des tests unitaires côté navigateur et une suite Playwright qui rejoue les parcours réels (passer un test, créer un groupe, comparer, se connecter) sur plusieurs navigateurs et sur mobile.
- Image Docker construite par l’intégration continue ; le déploiement fait servir la nouvelle version avant d’arrêter l’ancienne, pour qu’aucun visiteur ne tombe sur une page d’erreur pendant une mise à jour.
- Sentry côté serveur et côté navigateur, avec un filtrage du bruit propre aux navigateurs intégrés d’Instagram, aux WebView mobiles et aux traducteurs automatiques.
Growth & SEO
- Module d’analyses maison : une commande qui sort en JSON l’entonnoir complet, les canaux d’acquisition, les groupes, les partages et une série de règles d’alerte automatiques. C’est l’outil que j’interroge pour piloter le projet, et c’est de là que sortent tous les chiffres de cette page.
- Attribuer chaque test à son vrai point d’entrée : chaque test terminé est relié à la page par laquelle la personne est arrivée et au lien qu’on lui a transmis. C’est ce qui m’a appris que près de 40 % du volume, selon mon estimation, passe par une personne qui envoie le lien à tout un groupe, et non par un visiteur isolé.
- Contenu lisible par les IA : un fichier
llms.txtpar langue qui liste tous les tests et tous les profils, une page qui décrit aux assistants les caractéristiques de chaque test, unrobots.txtqui adresse nommément les robots d’indexation IA, et des données structurées sur toutes les pages. - Surveiller sa place dans les réponses des IA : des questions posées régulièrement à ChatGPT dans les mêmes termes, et une alerte quand les arrivées depuis une IA chutent sur une page. C’est ainsi que j’ai vu Profilia disparaître des recommandations sur le DISC en anglais, puis sur les archétypes de Jung, à chaque fois dans les jours qui ont suivi la publication d’un test concurrent.
- Blog de 105 articles par langue, soit 525 au total, avec un maillage dense entre articles, tests et profils pensé autour des intentions de recherche.
Stack et choix techniques
J’ai hésité à partir sur Next.js, puis j’ai choisi Laravel pour itérer rapidement sur l’administration, les files d’attente et les migrations, sans réinventer une API.
La première version du front tournait sur Inertia.js et React 19, avec un conteneur Node dédié pour le rendu côté serveur. C’était confortable à écrire, mais pour un site dont l’essentiel du trafic atterrit sur des pages de contenu (blog, profils, pages de tests), c’était surdimensionné : environ 190 Ko de JavaScript compressé à charger pour afficher un article.
Je suis donc revenu à Blade et Alpine.js : le serveur rend directement, Alpine ne prend la main que là où c’est nécessaire, c’est-à-dire le déroulé du test, le partage, le Mode Groupe et l’ADN. Le poids du JavaScript a été divisé par trois à quatre selon les pages, il n’y a plus de conteneur Node en production, et il ne reste qu’un seul paradigme à maintenir. Plus des deux tiers des visiteurs sont sur téléphone, souvent dans le navigateur intégré d’une application : chaque kilo-octet évité compte.
PostgreSQL plutôt que MySQL pour les requêtes analytiques de l’administration, qui manipulent beaucoup de regroupements et de séries temporelles.
Le choix dont je suis le plus content n’est pas dans la pile technique, c’est d’avoir traité la mesure comme une fonctionnalité du produit et pas comme un tableau de bord qu’on regarde de temps en temps. Sans ça, je serais encore en train de croire que je fais du SEO pour Google, et je n’aurais jamais vu que mes utilisateurs les plus précieux sont des professeurs.
Résultats
La 1 000e personne à terminer un test est arrivée le 1er août, après 141 jours. Le cap des 3 000 a été franchi un mois plus tard, le 1er septembre, celui des 5 000 le 22 septembre. Le volume est passé de 22 tests terminés en mars à 498 en juillet, puis 1 923 en août ; il tourne depuis autour de 3 000 sur trente jours glissants.
Plus des deux tiers de ces tests sont passés depuis un téléphone. La durée médiane d’un test est de six minutes. Et une part croissante n’est pas le fait d’individus isolés : des classes au Mexique, au Guatemala, en Chine ou au Québec, des équipes en formation, qui passent le même test dans la même heure.
Côté acquisition, sur les trente derniers jours, Bing amène le plus de tests commencés (512), devant ChatGPT (323) et Google (238). Les assistants IA pèsent au moins 10 % des tests terminés, contre 5 % en juin. C’est un plancher : une application mobile qui n’indique pas sa provenance ne se distingue pas d’une visite directe. Cette part était de 31 % en août ; elle a reculé dans les jours qui ont suivi la publication de tests par des concurrents mieux établis. C’est la limite de ce canal, et c’est ce qui oriente aujourd’hui le travail vers les enseignants et les formateurs, qui reviennent et font circuler le lien.
Si vous voulez parler de la façon dont c’est construit, ou que vous montez quelque chose de comparable, écrivez-moi.